


随着人工智能技术从云端向终端加速下沉,AI边缘计算正在成为企业数字化转型的关键基础设施。无论是智能制造、智慧零售还是安防监控,选择合适的边缘AI硬件并完成高效的软件部署,直接决定了项目能否真正落地。本文将从硬件选型、软件框架、部署优化三个维度,为你提供一份实用的AI边缘计算落地指南。
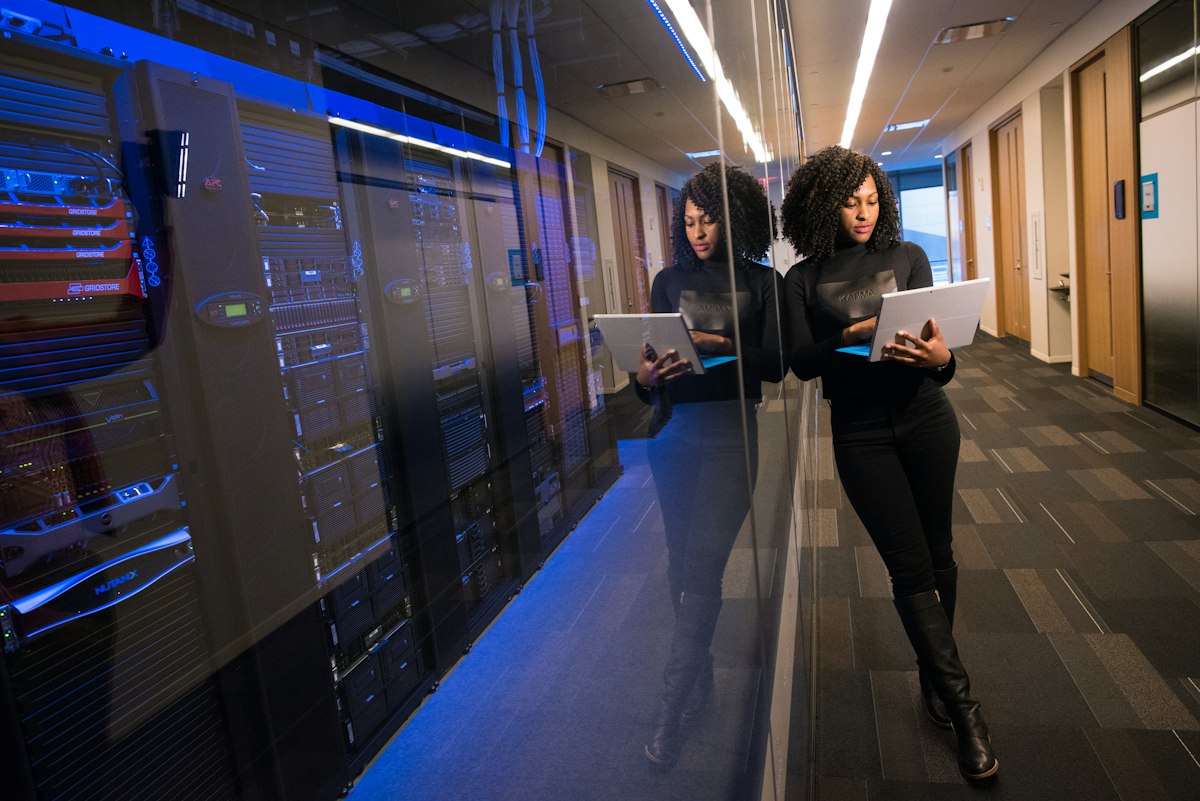
一、AI边缘计算硬件选型的核心指标
边缘计算场景下,硬件资源受限是常态。与云端GPU集群不同,边缘设备需要在功耗、算力、成本之间找到平衡点。选型时需要重点关注以下几个核心指标:
1. 算力(TOPS)与能效比
TOPS(每秒万亿次运算)是衡量AI芯片算力的基本单位,但单纯看TOPS数字意义不大,更重要的是能效比(TOPS/W)。例如,某款NPU标称8 TOPS算力,功耗仅5W,能效比达到1.6 TOPS/W,在电池供电场景下远优于15W功耗的方案。选型时务必结合实际功耗预算来评估真实可用算力。
2. 内存带宽与容量
AI推理过程中,模型参数和中间激活值需要频繁读写内存。内存带宽不足会成为算力瓶颈——芯片算力再高,数据喂不进去也是浪费。建议选择至少支持LPDDR4x及以上规格的硬件平台,内存容量不低于2GB(轻量模型)或4GB(多模型并行)。
3. 接口丰富度与扩展性
边缘设备通常需要对接摄像头、传感器、工业总线等多种外设。选型时要确认硬件是否提供足够的CSI摄像头接口、GPIO、I2C、SPI、USB 3.0以及千兆以太网口。工业场景还需关注宽温工作范围(-40°C至85°C)和防尘防潮等级。
二、主流边缘AI软件框架对比
硬件确定后,软件框架的选择同样关键。不同的框架在模型兼容性、推理性能、开发便捷性上各有取舍。
1. ONNX Runtime:通用性最强的跨平台方案
ONNX Runtime由微软开源,支持几乎所有主流硬件后端(CPU、GPU、NPU、VPU),是跨平台部署的首选。它的优势在于模型格式统一——PyTorch、TensorFlow训练的模型均可导出为ONNX格式,一次转换到处运行。缺点是对特定NPU的加速支持依赖厂商提供的Execution Provider,深度优化能力有限。
2. TensorRT:NVIDIA平台的性能王者
如果边缘硬件选的是Jetson系列(Nano、Orin等),TensorRT几乎是必选项。它通过层融合、精度量化(INT8/FP16)、内核自动调优等技术,可将推理速度提升2-5倍。但TensorRT仅支持NVIDIA GPU,且编译后的引擎不可跨平台迁移,需要在使用前充分测试精度损失。
3. TFLite + NNAPI:移动端轻量部署的经典组合
面向Android设备或嵌入式Linux平台,TensorFlow Lite配合Android NNAPI或Linux VPU驱动,能实现高效的移动端推理。TFLite模型体积小(通常5MB以内),支持INT8量化,适合人脸识别、姿态估计等轻量任务。但处理大模型(如YOLOv8)时性能不如专用NPU方案。
三、部署优化的实战技巧
选好硬件和框架只是开始,真正让系统跑起来还需要做大量部署优化工作。
1. 模型量化:用1%的精度损失换3倍速度提升
将FP32模型量化为INT8,是最有效的单点优化手段。以YOLOv8s为例,FP32模型约22MB,INT8量化后仅5.5MB,推理速度在RK3588 NPU上从18FPS提升到55FPS,mAP精度损失仅0.8%。建议使用训练后量化(PTQ)快速验证效果,对精度敏感的场景再考虑量化感知训练(QAT)。
2. 流水线并行:让预处理和推理重叠执行
很多边缘应用的瓶颈不在推理本身,而在图像预处理(缩放、归一化)和数据传输。通过多线程流水线设计——一个线程做摄像头采集和预处理,另一个线程做推理,第三个线程做后处理和结果输出——可以显著提升整体吞吐量。在RK3588平台上,这种优化可将端到端延迟从120ms降到45ms。
3. 动态批处理:应对多路视频流场景
当边缘设备需要同时处理多路摄像头视频时,逐帧推理效率极低。动态批处理将多路输入合并为一个batch送入推理引擎,充分利用NPU的并行计算能力。实测在8路1080P视频流场景下,batch=4相比逐帧处理吞吐量提升约2.8倍,但会增加约30ms的缓冲延迟,需要根据业务实时性要求权衡。
四、从原型到量产的关键注意事项
实验室里跑通demo不等于量产成功。从原型到量产,有几个容易被忽视的问题:
散热设计:边缘AI芯片满载功耗通常在5-15W,被动散热在环境温度35°C以上时会出现严重降频。量产产品必须做热仿真,必要时加入散热片或主动风扇。
OTA更新机制:模型迭代是常态,部署时必须设计可靠的OTA更新流程,包括模型版本管理、A/B回滚机制、更新失败恢复等。建议将模型文件与固件分离存储,支持独立更新。
监控与告警:边缘设备数量多、分布广,必须建立统一的监控平台,实时采集推理延迟、温度、内存占用等指标,设置异常告警阈值。开源方案可使用Prometheus + Grafana搭建监控看板。
结语
AI边缘计算的落地不是简单的“买硬件+跑模型”,而是一个涉及芯片选型、框架适配、性能优化、工程化部署的系统工程。趣凡科技在AI软硬件解决方案领域拥有丰富经验,从边缘计算硬件定制到AI模型部署优化,为企业提供一站式技术服务。如果你正在规划AI边缘计算项目,欢迎访问趣凡科技官网了解更多解决方案详情。